9월 28일 뉴스모음에서 COSA-GS 를 소개하며 "플랫폼이 달라도 복원 결과가 비트 단위로 같다"는 특징을 옮겨 적었습니다. ZIP 같은 일반 압축은 어느 기기에서 풀어도 원래 파일과 똑같이 나오므로, 기기에 따라 복원 결과가 달라질 수 있다는 전제부터 낯설었습니다. 학습 기반 압축에서 실제로 그런 일이 생기는지, 정수 연산으로 막을 수 있는지 공개된 코드로 확인했습니다. 사진 301장으로 장면 하나를 학습시켜 압축하고, GPU 에서 만든 압축 파일을 같은 노트북의 CPU 에서 복원했습니다.
3D 가우시안 스플래팅 장면 파일이 큰 이유
3D 가우시안 스플래팅(3DGS)은 한 장소를 여러 방향에서 촬영한 사진으로 3차원 장면을 만들고, 촬영하지 않은 방향의 화면까지 실시간으로 그리는 기술입니다. 장면은 3차원 가우시안 수십만~수백만 개로 이루어집니다. 가우시안은 위치·크기·회전으로 모양이 정해지는 타원체 모양의 반투명한 점이고, 각자 색과 불투명도를 가집니다. 화면을 그릴 때는 가우시안을 카메라 화면에 투영해 가까운 것부터 겹쳐 칠합니다.
가우시안마다 저장할 값이 수십 개라 장면 파일이 큽니다. COSA-GS 가 압축하는 Scaffold-GS 는 가우시안을 하나씩 저장하지 않고 앵커(anchor)라는 기준점 단위로 저장하는 표현입니다. 앵커 하나가 가우시안 10개를 담당하며 좌표, 32차원 특징 벡터, 가우시안 10개의 위치 오프셋, 크기 값을 가집니다. 색·불투명도·회전은 작은 신경망이 특징 벡터와 카메라에서 본 방향·거리로 계산합니다. 이렇게 줄여도 이번 실험의 장면은 앵커 234,908개, 파일 74.3MB 였습니다.
학습 기반 압축의 복원이 기기에 따라 실패하는 이유
압축의 마지막 단계는 엔트로피 부호화입니다. 자주 나오는 값에는 짧은 비트열을, 드물게 나오는 값에는 긴 비트열을 붙여 전체 길이를 줄이는 방법입니다. 비트열 길이를 정하려면 값마다 나올 확률을 알아야 하므로, 압축률은 확률을 얼마나 정확히 예측하느냐에 달려 있습니다.
COSA-GS 는 이 확률을 신경망으로 예측합니다. 앵커 속성값마다 신경망이 정규분포의 평균과 표준편차를 계산합니다. 그리고 실제 값과 평균의 차이를 정해진 간격으로 반올림한 정수를 그 분포에 맞춰 부호화합니다. 이 정수를 심볼(symbol)이라고 부릅니다. 예측이 정확할수록 심볼이 0 근처에 모여 짧은 비트열이 됩니다. 저장소 코드는 표준편차를 그대로 쓰지 않고, 미리 만들어 둔 확률표 128개 가운데 하나의 인덱스로 반올림해 고릅니다. 복원은 이 과정을 거꾸로 따라갑니다.
- 앵커 좌표와 앞서 복원한 값으로 확률 예측 신경망을 실행합니다.
- 신경망 출력에서 평균과 확률표 인덱스를 얻습니다.
- 그 확률표로 비트스트림에서 심볼을 하나 읽습니다.
- 평균에 심볼과 간격을 곱한 값을 더해 속성값을 복원하고, 이 값을 다음 예측의 입력으로 씁니다.
복원하는 쪽이 압축할 때와 같은 확률표 인덱스를 얻어야 비트열을 심볼로 되돌릴 수 있습니다. 이 코드가 쓰는 rANS(range Asymmetric Numeral Systems)는 산술 부호화와 비슷한 압축률을 더 빠르게 내는 엔트로피 부호화 방식으로, 정수 상태값 하나를 갱신하며 심볼을 비트열로 바꿉니다. 앞 심볼을 해석한 결과가 다음 심볼을 해석하는 상태로 이어지므로, 확률표 인덱스가 한 곳에서만 달라도 그 뒤 심볼이 연달아 어긋납니다.
여기서 부동소수점 연산이 문제가 됩니다. 부동소수점 덧셈은 순서를 바꾸면 마지막 자리가 달라질 수 있고, GPU 와 CPU 는 같은 행렬곱도 다른 순서와 명령으로 계산합니다. 대부분의 값은 반올림하면 같은 인덱스가 되지만, 신경망 출력이 104.5 같은 반올림 경계 바로 근처에 있으면 두 기기가 서로 다른 인덱스를 고릅니다. 복원할 값이 수백만 개이면 이런 경계 사례가 몇 개쯤 나올 수 있습니다.
COSA-GS 의 두 가지 설계
- 주변 앵커를 참조하지 않고 앵커 자신의 정보만으로 확률을 예측합니다. 앞선 기법인 HAC++ 는 해시 격자에서 주변 공간의 정보를 모아 확률을 예측했습니다. COSA-GS 는 앵커 자신의 좌표와, 앵커마다 학습하는 작은 잠재 변수만 씁니다. 신경망은 선형 변환과 GELU 활성화 함수로만 이루어집니다. 논문은 Mip-NeRF360 의 flowers 장면 복원 시간이 HAC++ 24.95초, COSA-GS 0.1279초였다고 보고합니다.
- 확률을 예측하는 신경망을 정수 연산으로만 실행합니다. 가중치와 입력은 8비트 정수, 곱을 더해 가는 누산은 32비트 정수입니다. 층의 출력은 2의 20제곱(1,048,576)을 1 로 보는 고정소수점 정수로 바꿔 GELU 를 적용하고, 다음 층에 넣기 전에 다시 8비트로 줄입니다. GELU 는 0~6 구간을 1/512 간격으로 미리 계산한 표에서 정수 보간으로 구합니다. 정규분포 확률표 128개도 미리 정수로 만들어 둡니다. 정수 덧셈은 순서를 바꿔도 결과가 같으므로 어느 기기에서 실행해도 같은 확률표 인덱스가 나옵니다.
정수 추론 모델을 만드는 방법은 두 가지입니다. 논문의 기본 설정은 양자화 인식 학습(QAT)으로, 학습 중에 정수 반올림을 미리 적용해 신경망이 정수 연산에 적응하게 합니다. 저장소에는 학습을 마친 부동소수점 모델을 정수 연산용으로 바꾸는 학습 후 양자화(PTQ) 스크립트도 있습니다. 논문은 GPU·CPU 조합 세 가지(NVIDIA 5880 Ada·AMD EPYC 9654, RTX 4090·EPYC 7R32, V100·Intel Xeon Gold 6258R)에서 비트스트림 45개를 복원해 모두 같은 심볼을 얻었다고 보고합니다.
실험 구성
| 항목 | 내용 |
|---|---|
| GPU | NVIDIA GeForce RTX 5080 Laptop GPU 16GB (계산 능력 12.0) |
| CPU | Intel Core Ultra 9 285H (16코어) |
| 실행 환경 | Docker 컨테이너(Ubuntu 22.04, CUDA 13.0.1), Python 3.10, PyTorch 2.9.1 |
| 코드 | COSA-GS 저장소 d81f98a (2026-09-25) |
| 데이터 | Tanks and Temples 의 train 장면, 사진 301장(학습 263장·평가 38장), 980x545 |
| 학습 | Scaffold-GS 15,000회 → 압축 학습 30,000회, λ=0.001 |
| 정수 추론 모델 | 압축 학습을 마친 부동소수점 모델을 PTQ 로 변환 |
λ 는 파일 크기와 화질 가운데 어느 쪽을 더 중시할지 정하는 값으로, 논문이 Tanks and Temples 에 쓴 다섯 값 가운데 화질을 가장 중시하는 값입니다. 논문과 다르게 진행한 부분이 두 가지 있습니다.
- 정수 추론 모델을 QAT 대신 PTQ 로 만들었습니다. QAT 로 압축 학습을 다시 30,000회 하면 이 노트북에서는 초당 1.5회(부동소수점 모델 학습과 함께 실행한 상태)로 5시간 넘게 걸릴 것으로 보여 중단했습니다. 기기와 무관하게 같은 결과가 나오는 성질은 추론을 정수로 하는 데서 나오므로 두 방식이 같습니다. 달라지는 것은 화질과 크기입니다.
- 정수 행렬곱 커널 한 줄을 고쳤습니다. 저장소가 계산 능력 12.0 GPU 용으로 요청하는 CUTLASS 2.x 커널 정의가 없어 컴파일에 실패했습니다.
gemm.cu에서 Ampere 세대(계산 능력 8.0)용 정수 텐서 코어 커널을 이 GPU 용으로 컴파일하도록 바꿨습니다. 정수 행렬곱은 어느 커널로 계산해도 값이 같으므로 결과에 영향이 없습니다.
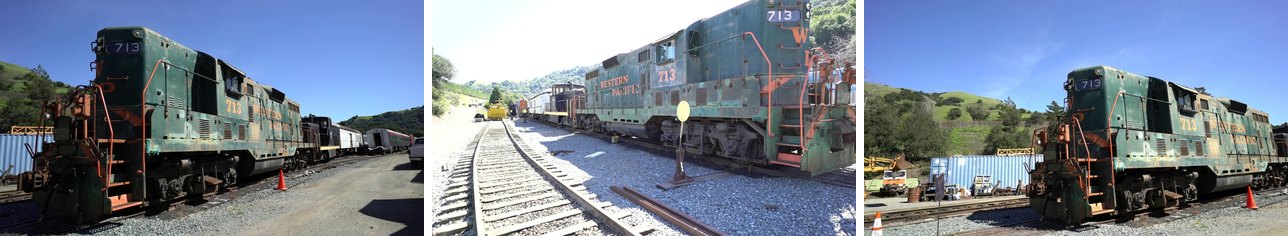
입력: 사진 301장
학습은 두 단계입니다. 먼저 Scaffold-GS 를 15,000회 학습해 압축 전 장면을 만들고, 그 장면을 COSA-GS 로 30,000회 더 학습하면서 압축합니다. 두 번째 단계에서는 화질 손실과 예상 파일 크기를 함께 줄이도록 앵커 속성과 확률 예측 신경망을 같이 최적화하며, 화면에 기여하지 않는 가우시안을 제거합니다. 실행한 명령은 저장소 안내와 같고, 중단에 대비해 5,000회마다 중간 저장하는 옵션만 더했습니다.
python -m scaffold.train config/scaffold15k_tandt.yaml \
  data.scene=train data.model_path=outputs/scaffold15k_tandt/train
python -m scaffold_codec.train config/codec30k_tandt.yaml \
  data.model_path=outputs/tandt_30k/train_lmb0.001 train.lambda_rate=0.001 \
  train.checkpoint_interval=5000
python -m scaffold_codec_int.convert_and_evaluate --config config/codec30k_tandt.yaml \
  --checkpoint outputs/tandt_30k/train_lmb0.001/checkpoints/final.pt \
--output outputs/tandt_30k_ptq/train_lmb0.001 --save-images첫 단계의 평가 결과입니다. 학습에 796초가 걸렸고 앵커 234,908개가 만들어졌습니다.
{
  "ours_15000": {
    "SSIM": 0.8053940534591675,
    "PSNR": 21.789690017700195,
    "LPIPS": 0.2315526008605957,
    "anchors": 234908,
    "train_seconds": 796.1930676970001
  }
}압축 결과
평가용 사진 38장과 같은 시점에서 화면을 렌더링해 비교했습니다. PSNR 과 SSIM 은 원본 사진과 얼마나 비슷한지를 나타내며 높을수록 좋습니다. LPIPS 는 사람이 느끼는 차이를 신경망으로 추정한 값으로 낮을수록 좋습니다. 논문 값은 표의 MiB 를 MB 로 환산했습니다.
| 표현 | 파일 크기 | PSNR | SSIM | LPIPS |
|---|---|---|---|---|
| Scaffold-GS (압축 전) | 74.3MB | 21.79dB | 0.805 | 0.232 |
| COSA-GS 부동소수점 모델 | 4.88MB | 22.78dB | 0.826 | 0.209 |
| COSA-GS 정수 추론 모델(PTQ) | 5.77MB | 22.78dB | 0.826 | 0.209 |
| 논문 부동소수점 모델 | 5.24MB | 22.90dB | 0.826 | 0.207 |
| 논문 정수 추론 모델(QAT) | 5.29MB | 22.84dB | 0.827 | 0.207 |
부동소수점 모델은 74.3MB 를 4.88MB, 약 15분의 1 로 줄였습니다. 압축 학습 중 화면에 기여하지 않는 가우시안을 제거하면서 앵커도 234,908개에서 177,063개로 줄었습니다. PSNR 이 압축 전보다 1dB 가량 높은 것은 압축 단계에서 30,000회를 더 학습했기 때문입니다. 논문 값과 비교하면 파일이 7% 작고 PSNR 이 0.12dB 낮아 같은 수준입니다. 학습 시간은 Scaffold-GS 796초, 압축 학습 2,855초였습니다.
PTQ 로 만든 정수 추론 모델은 화질이 같았지만 파일 크기가 18% 컸습니다. 정수로 바꾼 신경망의 평균 예측이 덜 정확해져 부호화할 차이, 곧 심볼이 커졌기 때문입니다. 특징 벡터 심볼의 평균 절댓값이 부동소수점 모델 2.62 에서 정수 추론 모델 3.05 로 커졌습니다. 논문의 QAT 모델은 부동소수점 모델보다 1% 크므로, 이 차이를 줄이는 것이 QAT 의 역할입니다. 정수 추론 모델의 압축에는 0.15초, 복원에는 0.11초가 걸렸습니다(저장소 평가 스크립트가 첫 실행 1회를 제외하고 측정한 값).
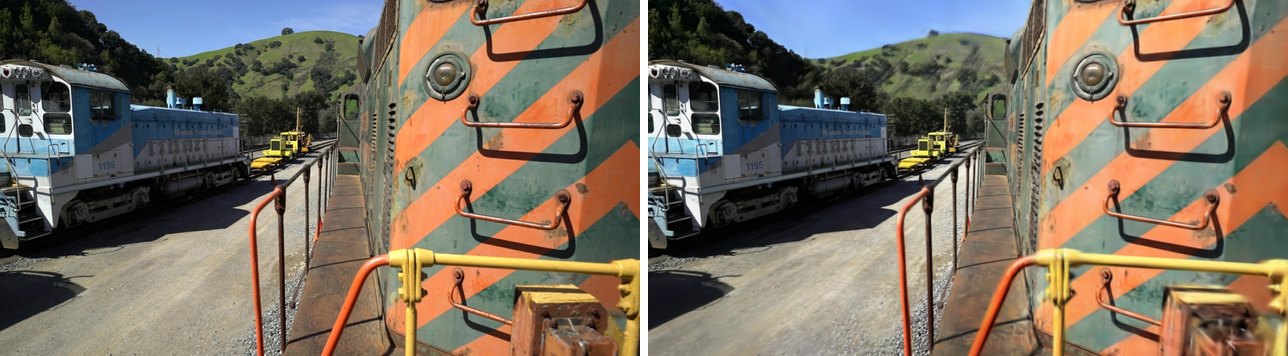
GPU 에서 압축한 파일을 CPU 에서 복원한 결과
압축은 GPU 에서 한 번만 하고, 같은 비트스트림을 GPU 와 CPU 에서 각각 복원했습니다. 압축할 때 부호화기가 쓴 확률표 인덱스와 심볼을 전부 기록해 두고, 복원할 때 복호기가 고른 인덱스와 읽어 낸 심볼을 하나씩 비교했습니다. 화면은 어느 쪽에서 복원했든 같은 GPU 로 렌더링했습니다. 비교한 심볼은 모델마다 8,512,845개입니다.
부동소수점 모델은 저장소 코드가 CPU 에서도 그대로 실행됩니다. 정수 추론 모델은 저장소의 정수 연산이 CUDA 전용이라 같은 규칙을 PyTorch 의 CPU 연산으로 다시 구현했습니다. 다시 구현한 연산이 CUDA 커널과 같은 값을 내는지는 무작위 입력 137,596,914개로 먼저 확인했습니다. 모든 입력에서 출력이 같았습니다.
| 모델 | 복원 기기 | 확률표 인덱스 불일치 | 심볼 불일치 | PSNR |
|---|---|---|---|---|
| 부동소수점 | GPU | 0 | 0 | 22.78dB |
| 부동소수점 | CPU | 3,390,293 | 6,586,463 (77.4%) | 11.32dB |
| 정수(PTQ) | GPU | 0 | 0 | 22.78dB |
| 정수(PTQ) | CPU | 0 | 0 | 22.78dB |
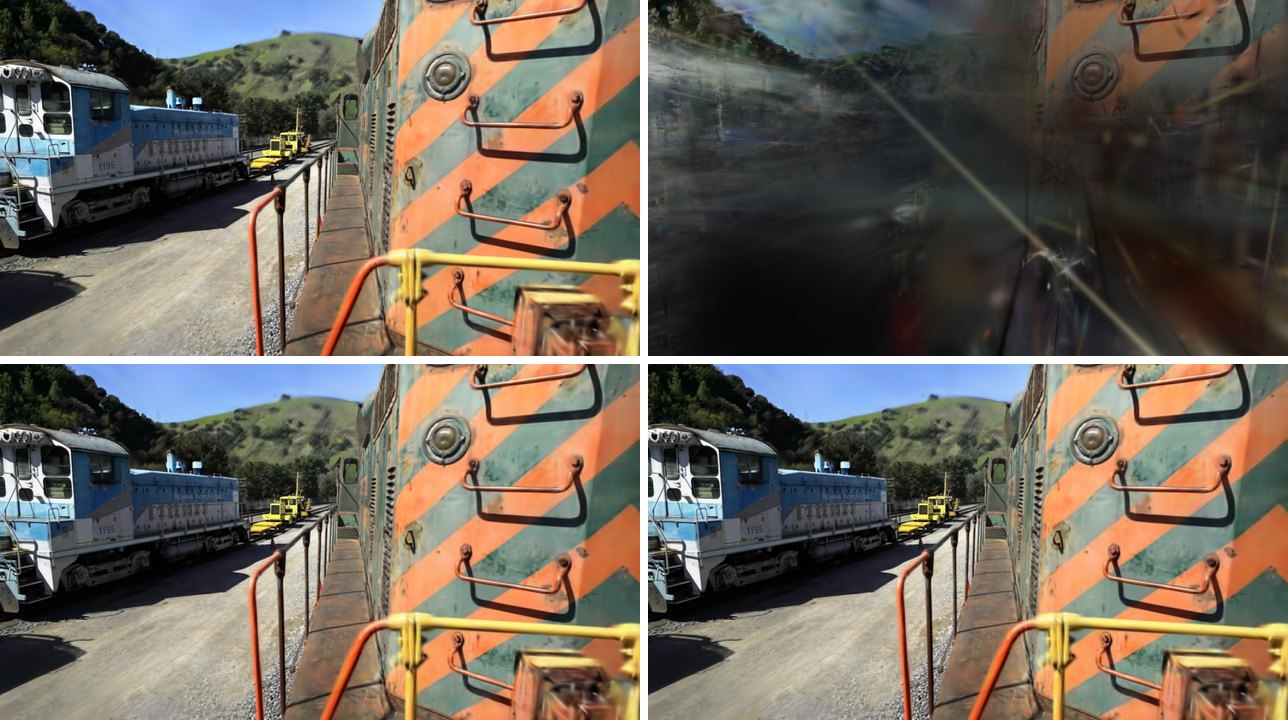
부동소수점 모델을 CPU 에서 복원하자 첫 번째 잠재 변수 채널의 117,352번째 값에서 처음으로 확률표 인덱스가 달랐습니다. 압축할 때는 45번 표를 썼는데 CPU 는 46번 표를 골랐습니다. 이 채널에서 인덱스가 다른 곳은 3곳뿐이었지만 그 뒤로 심볼 47,317개가 연달아 어긋났습니다. 잘못 복원한 잠재 변수가 다음 채널과 다른 속성의 확률 예측에 입력으로 쓰이면서 인덱스 불일치는 3,390,293곳으로 늘었습니다. 그 결과 전체 심볼 8,512,845개 가운데 6,586,463개(77.4%)가 일치하지 않았습니다. 앵커 좌표는 신경망을 쓰지 않고 공간을 여덟 칸씩 나누는 옥트리 방식으로 부호화하므로 두 기기의 결과가 같았습니다. 그러나 각 앵커의 속성값이 잘못 복원되어 화면을 알아볼 수 없게 되었습니다.
정수 추론 모델은 CPU 에서도 확률표 인덱스와 심볼 8,512,845개가 모두 같았고, 심볼 전체로 계산한 SHA-256 해시값(내용이 1비트만 달라도 완전히 달라지는 256비트 요약값)도 일치했습니다. 부동소수점으로 바꾼 최종 속성값까지 비트 단위로 같았고, 같은 GPU 로 렌더링한 평가 화면 38장도 파일 단위로 같았습니다. CPU 복원에는 21.2초가 걸려 GPU(0.45초)보다 느렸습니다. 다시 구현한 정수 연산을 최적화하지 않은 PyTorch 연산으로 실행했기 때문입니다.
비교 스크립트의 요약 출력입니다. 위는 부동소수점 모델, 아래는 정수 추론 모델을 CPU 에서 복원한 결과입니다. left 는 압축할 때 기록한 값이고, right 는 CPU 에서 복원한 값입니다.
{
  "coded_values": 8512845,
  "index_mismatch": 3390293,
  "symbol_mismatch": 6586463,
  "symbol_mismatch_ratio": 0.7737087894822471,
  "first_index_mismatch": {
    "stream": "anchor_latent_0",
    "position": 117352,
    "left_index": 45,
    "right_index": 46
  },
  "anchor_coords_equal": true,
  "offset_mask_equal": true,
  "left_sha256": "ebfefd0bb8b8c0af88dfb9c73a824d6035a0c7b8f7bd329bbe08c87ff453f824",
  "left_device": "cuda (NVIDIA GeForce RTX 5080 Laptop GPU)",
  "right_sha256": "7d9592ad9d5065628d75492540f3ce617a9db010d6dded2f314917a5de5a3ed5",
  "right_device": "cpu (x86_64)",
  "sha256_equal": false
}{
"coded_values": 8512845,
"index_mismatch": 0,
"symbol_mismatch": 0,
"symbol_mismatch_ratio": 0.0,
"first_index_mismatch": null,
"anchor_coords_equal": true,
"offset_mask_equal": true,
"left_sha256": "f5b1add751c3047f5cf22d8aa4cd8e874585320fa5039533fa7c37780befcdb4",
"left_device": "cuda (NVIDIA GeForce RTX 5080 Laptop GPU)",
"right_sha256": "f5b1add751c3047f5cf22d8aa4cd8e874585320fa5039533fa7c37780befcdb4",
"right_device": "cpu (x86_64)",
"sha256_equal": true
}정리
- 학습 기반 압축은 복원하는 기기가 압축한 기기와 같은 확률을 계산해야 합니다. 부동소수점 신경망으로 확률을 예측하는 모델은 GPU 에서 만든 파일을 CPU 에서 복원하자 확률표 인덱스가 처음 3곳에서 달랐고, 그 영향이 뒤 단계로 이어져 심볼의 77.4% 가 어긋나고 화면이 깨졌습니다.
- COSA-GS 의 정수 추론은 이 문제를 연산 규칙으로 방지합니다. CUDA 커널을 CPU 용으로 다시 구현한 코드로 복원해도 심볼 8,512,845개가 모두 같았습니다.
- PTQ 로 만든 정수 추론 모델은 화질이 같은 대신 파일이 18% 커졌습니다. 논문은 QAT 로 이 차이를 1% 로 줄였다고 보고합니다.
- 기기 간 일치가 보장되는 범위는 엔트로피 복호화로 얻은 심볼과 신경망에 다시 들어가는 고정소수점 값까지입니다. 논문도 렌더링한 화면까지 비트 단위로 같다고 보장하지는 않는다고 밝힙니다.
- 이번 실험은 장면 하나, λ 값 하나, 노트북 한 대의 GPU 와 CPU 에서 진행했습니다. 종류가 다른 GPU 사이의 복원은 확인하지 못했습니다. 정수 추론 모델도 논문 기본값인 QAT 가 아니라 PTQ 로 만들었습니다.