CCTV 영상으로 시정거리를 추정하는 연구 모델에서, 같은 관측 지점의 카메라 여러 대가 같은 시각에 촬영한 영상의 예측값을 결합하는 후처리 규칙을 연구 기준선으로 사용하고 있습니다. 이 규칙은 개발 자료에서 짙은 안개를 2km 넘게 추정하는 비율을 74.4%에서 58.1%로 줄였습니다. 그러나 이후 독립 검증에 사용한 두 자료에는 보고값 1km 미만 사례가 한 건도 없어 안개 관련 지표는 확인하지 못한 상태였습니다. 이번에는 기준 모델이 학습하지 않은 관측 지점 세 곳의 영상을 새로 처리해 그 지표를 확인했습니다.
기준 모델과 다중 시야 게이트의 구성
기준 모델은 영상 인코더를 학습하지 않고 고정합니다. 전체 화면은 224x224 로, 관심 영역(ROI)은 392x392 로 크기를 조정해 DINOv2-small 에 입력합니다. 이어서 화면마다 CLS 토큰 1개와 패치 격자를 4x4 로 평균한 토큰 16개, 밝기·대비 같은 광도 특징 32개를 추출합니다. 관심 영역은 카메라마다 수평선과 수면을 담도록 사람이 지정한 사각형입니다. 이렇게 구성한 13,120차원 특징을 입력으로 XGBoost 회귀 모델 두 개(로그 제곱오차, 0.75 분위수)를 학습하고, 두 모델의 미터 단위 출력을 평균합니다.
게이트는 정답 라벨을 쓰지 않는 후처리입니다. 같은 지점·같은 분에 촬영된 시야가 두 개 이상이면 시야별 예측의 기하평균을 구하고, 그 값이 8km 미만이면 예측이 낮은 쪽 절반 시야의 기하평균을 출력합니다. 8km 이상이면 각 시야의 원래 예측을 그대로 유지합니다. 시야 하나가 안개를 놓쳐도 다른 시야가 낮게 추정하면 출력이 낮아지도록 만든 규칙입니다.
def gate(B, station, minute, members):
    """research_r9_arm_g_gate_v1 exactly as registered (register.py): log10 with a 1 m floor."""
    lb = np.log10(np.maximum(B, 1.0))
    mean, low = np.full(len(B), np.nan), np.full(len(B), np.nan)
    groups = defaultdict(list)
    for i in np.flatnonzero(members):
        groups[(station[i], minute[i])].append(i)
    sizes = np.zeros(len(B), dtype=int)
    for index in groups.values():
        values = np.sort(lb[index])
        mean[index] = values.mean()
        low[index] = values[:(len(values) + 1) // 2].mean()
        sizes[index] = len(index)
    prediction = B.copy()
    fire = members & (10 ** mean < 8000)
    prediction[fire] = 10 ** low[fire]
    return prediction, fire, sizes
결과를 보기 전에 고정한 평가 조건
판정 기준은 결과를 확인하기 전에 프로토콜 파일로 고정했습니다. 평가 대상은 세 지점에서 보고값이 정확값이고 분석 가능하며 20km 미만인 50,149건입니다. 보고값 20km 는 센서 상한이라 실제 값을 알 수 없으므로 기준선을 등록할 때와 같이 제외했습니다. 새 지점 카메라 9대의 관심 영역은 보고값 15km 이상인 맑은 낮 영상을 카메라마다 6장씩 확인해 지정했습니다. 구조물이 화면 대부분을 가린 카메라 한 대는 기존 규칙대로 전체 화면을 관심 영역으로 사용했습니다.
| 지표 | 정의 |
|---|---|
| 숨은 안개 | 보고값 550m 미만인 영상 중 2km 를 넘게 추정한 비율 |
| 1km 미만 재현율 | 보고값 1km 미만인 영상 중 1km 미만으로 추정한 비율 |
| 오경보 | 보고값 15km 이상인 영상을 5km 미만으로 추정한 건수 |
신뢰구간은 지점·날짜 418개 군집을 단위로 2,000회 복원추출하는 군집 부트스트랩으로 산출했습니다. 재현율 변화의 단측 95% 하한이 0보다 크고 숨은 안개 변화의 단측 95% 상한이 0보다 작으면 확인으로 판정합니다. 두 지표가 모두 개선 방향이지만 신뢰구간 중 하나라도 0을 포함하면 방향만 일치로 판정하기로 했습니다.
특징 대조는 통과했는데 모델 대조가 실패한 원인
먼저 영상 109,301장의 특징을 GPU 로 추출했습니다. 이어서 기존 특징 캐시에 포함된 개발 자료 64장의 특징을 원본 JPEG 에서 다시 추출해 캐시 값과 비교했습니다. 64장 모두 FP16 저장값이 비트 단위로 같았습니다. 그런데 같은 캐시의 개발 자료 4,096장에 모델을 적용해 저장된 예측과 비교하자 로그 제곱오차 모델은 최대 7,216.8m, 분위수 모델은 최대 6,037.8m 의 차이가 발생했습니다. 이 단계에서 새 지점의 예측은 생성하지 않고 작업을 중단했습니다.
원인은 비교 대상 캐시였습니다. 연구 서버에는 같은 13,120차원 형식의 캐시가 두 개 있었습니다. 625,364행 캐시는 관심 영역을 224x224 로 인코딩했고, 기준 모델이 실제로 학습한 247,673행 캐시는 전체 화면 열을 앞 캐시에서 비트 단위로 복사한 뒤 관심 영역 열만 392x392 로 다시 계산한 것이었습니다. 차원과 열 배치가 같아 모델은 오류 없이 예측값을 출력했고, 그 값만 저장된 예측과 달랐습니다.
관심 영역 열만 392x392 로 다시 추출해 앞서 추출한 전체 화면 열과 결합했습니다. 기준 모델이 학습한 캐시의 64장과 다시 비교한 결과 모두 비트 단위로 같았습니다. 모델 대조의 최대 차이도 로그 제곱오차 모델 1.27m, 분위수 모델 0.034m 로 줄었습니다. 저장된 예측은 CUDA 로, 이번 예측은 CPU 로 계산했으므로 남은 차이는 부동소수점 연산의 누적 순서 차이에서 비롯된 수준입니다. 허용 오차를 2m 로 정하고, 이 변경을 새 지점 예측을 생성하기 전에 프로토콜 변경 이력으로 기록했습니다.
특징 대조만으로는 모델이 학습 때와 같은 입력을 받는지 보장되지 않습니다. 새 자료에 모델을 적용하기 전에 저장된 예측을 다시 계산하는 모델 대조를 함께 수행해야 잘못된 캐시를 참조하는 오류를 탐지할 수 있습니다.
학습에 쓰지 않은 세 지점의 결과
| 지표 | 기준 모델 | 게이트 적용 | 변화 | 단측 95% 경계 |
|---|---|---|---|---|
| R² | 0.3104 | 0.3256 | +0.0152 | 하한 +0.0060 |
| 상대오차 분산 | 10.73 | 4.09 | -6.65 | 상한 -3.62 |
| ±2% 일치율 | 2.975% | 2.971% | -0.004%p | 하한 -0.071%p |
| 숨은 안개 | 68.45% (640/935) | 42.46% (397/935) | -25.99%p | 상한 -19.74%p |
| 1km 미만 재현율 | 12.85% (158/1,230) | 14.23% (175/1,230) | +1.38%p | 하한 -1.55%p |
| 오경보 | 181 | 201 | +20 | 상한 +60 |
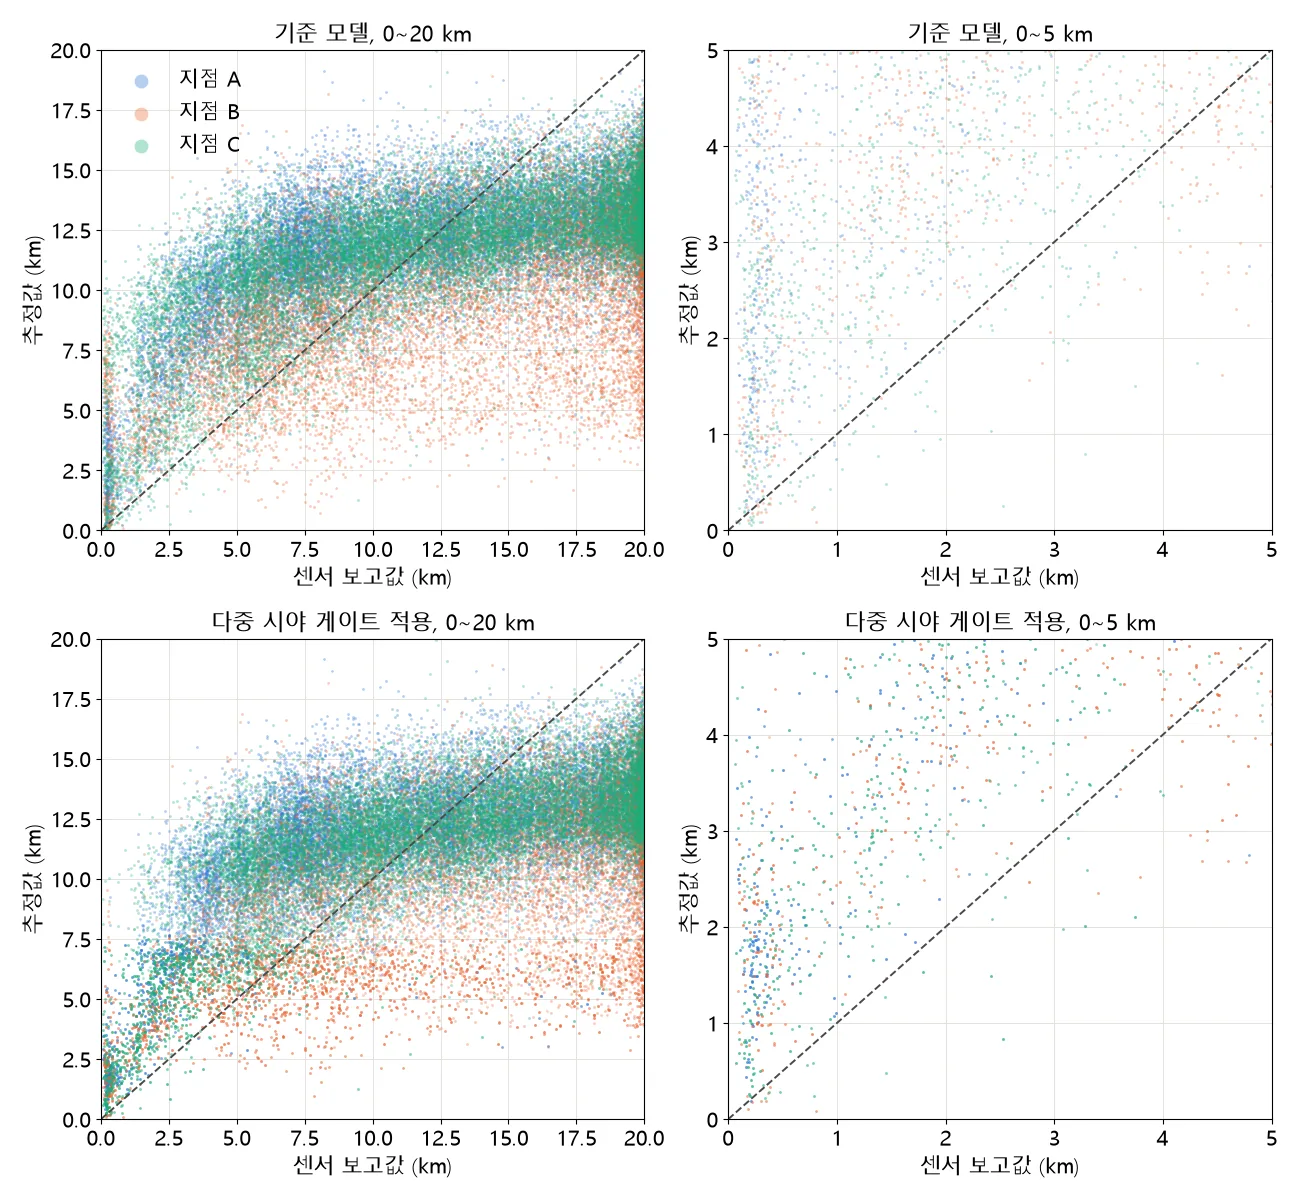
숨은 안개는 25.99%p 줄었고 단측 95% 상한도 -19.74%p 여서 확인 기준을 충족했습니다. 1km 미만 재현율은 1.38%p 올랐지만 하한이 -1.55%p 로 0 미만이어서 사전 기준상 방향만 일치에 해당합니다. 오경보는 181건에서 201건으로 11% 늘었습니다. R² 는 0.310 에서 0.326 으로 올랐고 상대오차 분산은 10.73 에서 4.09 로 줄었습니다.
지점별 성능 차이와 민감도 분석
| 지점 | 숨은 안개 | 1km 미만 재현율 | 오경보 |
|---|---|---|---|
| A | 65.65% → 35.73% | 9.56% → 7.33% | 9 → 11 |
| B | 69.42% → 51.20% | 15.18% → 16.07% | 170 → 188 |
| C | 71.02% → 42.05% | 14.41% → 19.82% | 2 → 2 |
숨은 안개는 세 지점 모두 줄었지만 재현율은 지점 A 에서 떨어졌습니다. 오경보 증가분 20건 중 18건은 지점 B 에서 발생했습니다. 지점 B 에서는 기준 모델이 보고값 15km 이상인 영상의 15.69% 를 이미 8km 미만으로 추정했고(지점 A 0.80%, 지점 C 0.26%), 게이트가 그중 일부의 예측값을 더 낮췄습니다.
사전에 정한 민감도 분석으로, 게이트를 적용할 때 평가 대상이 아닌 시야(보고값이 상한이거나 분석 불가인 영상)까지 포함해 같은 시각의 모든 시야를 결합했습니다. 운영 환경과 같은 조건입니다. 이 경우 숨은 안개는 45.67% 로 비슷했지만 재현율은 11.30% 로 기준 모델의 12.85% 보다 낮아졌습니다. 운영 환경에서는 영상의 라벨 상태를 알 수 없으므로, 재현율 개선은 이번 검증에서 재현되지 않은 것으로 판단했습니다.
Git 미참조 객체 정리
같은 날 연구 저장소의 .git 폴더가 15GB 인 것을 확인했습니다. 브랜치와 참조에서 도달 가능한 객체는 183MiB 였고 나머지는 어느 참조에도 연결되지 않은 객체였습니다. 남아 있는 참조 이름(refs/codex/turn-diffs/...)으로 보아 Codex 앱이 작업 단위마다 작업 트리 전체를 트리 객체로 저장한 스냅샷이 원인입니다. 이 저장소는 대용량 평가 산출물을 Git 으로 추적하지 않은 채 두고 있어, 스냅샷마다 해당 파일들까지 객체로 저장되었습니다. 이 객체들은 참조가 지워진 뒤에도 팩 파일에 그대로 남아 있었습니다.
Git 은 팩 안 미참조 객체의 경과 시간을 팩 파일의 수정 시각으로 판단합니다. 이 팩 파일은 수정 시각이 당일로 기록되어 있어 기본 유예 기간(2주)으로는 정리 대상이 되지 않았습니다. 이 저장소에 객체를 쓰는 다른 프로세스가 없음을 확인한 뒤 미참조 객체를 즉시 정리했습니다.
git rev-list --objects --all --disk-usage=human
git -c gc.cruftPacks=false gc --prune=now
git fsck --connectivity-only --no-dangling정리 후 .git 폴더 크기는 171MB 입니다. 브랜치 커밋 6개와 참조 8개는 그대로 유지되었으며 연결성 검사도 통과했습니다.
한계와 남은 과제
- 센서 보고값은 실제 시정거리의 확정값이 아닙니다. 세 지점의 보고값 1km 미만 사례는 1,230건이고 모두 11월부터 4월 사이 영상입니다.
- 재현율 개선이 확인되지 않았고 오경보가 늘었으므로 게이트를 운영 모델에는 적용하지 않았습니다. 연구 비교 기준으로만 유지합니다.
- 새 지점의 관심 영역은 맑은 날 영상 6장씩을 기준으로 설정했으며, 카메라 방향이 바뀐 시기는 점검하지 않았습니다.
- 특징 추출은 Quadro RTX 8000 한 장에서 두 번에 나눠 0.82 GPU시간이 소요되었으며, 처리 속도는 초당 72~83장이었습니다.