회의 녹음이나 인터뷰 영상을 글로 옮기는 서비스를 만들면서, 누가 언제 무엇을 말했는지를 함께 받아 적을 모델 조합을 정해야 했습니다. 처음에는 NVIDIA Sortformer 화자분리와 WhisperX 음성 인식을 기본 조합으로 두었습니다. 여기에 2026년 10월 기준으로 한국어를 지원하고 가중치가 공개되어 있으며 미세조정 방법이 있는 모델을 더해, 같은 데이터와 같은 GPU 에서 정확도·처리 속도·GPU 메모리를 측정했습니다. 목표는 실시간 처리가 아니라 녹음 파일 전체를 빠르고 정확하게 처리하는 것입니다.
화자별 전사를 이루는 두 단계
화자별 전사는 성격이 다른 두 작업으로 나뉩니다. 화자분리(speaker diarization)는 녹음의 각 구간이 누구의 목소리인지 나누는 작업으로, 이름은 모르고 화자 1·화자 2 처럼 구분만 합니다. 음성 인식(speech-to-text)은 말소리를 글자로 바꾸는 작업이며, 화자분리 결과와 합치려면 단어마다 말한 시각까지 구해야 합니다.
두 결과는 단어가 발화된 구간과 가장 오래 겹치는 화자에게 그 단어를 배정한 뒤, 같은 화자의 연속된 단어를 한 발화로 묶어 합칩니다. 이렇게 단계별 모델을 이어 붙이는 방식을 캐스케이드라고 부르고, 모델 하나가 화자·시각·내용을 한 번에 출력하는 방식을 통합형이라고 부릅니다.
비교한 모델
| 구분 | 모델 | 특징 |
|---|---|---|
| 화자분리 | Nemotron-3-Diarization (NVIDIA, 2026-09) | Sortformer 구조, 최대 8명, 매개변수 100M |
| 화자분리 | Streaming Sortformer v2 · v2.1 (NVIDIA) | 최대 4명, 매개변수 117M |
| 화자분리 | pyannote community-1 | 짧은 구간의 화자 임베딩을 군집화, 화자 수 제한 없음 |
| 화자분리 | DiariZen v2 범용판 · MLC 미세조정판 (BUT) | WavLM 기반, 가중치 비상업 라이선스 |
| 음성 인식 | WhisperX large-v3 · large-v3-turbo | faster-whisper 추론 + wav2vec2 단어 정렬 |
| 음성 인식 | BuzzASR-ko | Whisper large-v3 를 한국어 낭독 데이터로 미세조정 |
| 음성 인식 | Nemotron 3.5 ASR 0.6B (NVIDIA) | RNNT 구조, 단어 시각 출력 |
| 음성 인식 | Qwen3-ASR 1.7B · 0.6B (Alibaba) | Qwen3-ForcedAligner 로 단어 시각 계산 |
| 통합형 | VibeVoice-ASR (Microsoft) | 매개변수 8.3B, 화자·시각·내용을 JSON 으로 출력 |
모델 선정 기준은 한국어 공식 지원, 공개 가중치, 미세조정 방법, GPU 1장에서 작업 메모리 15GB 이하 실행 네 가지입니다. 모든 측정은 NVIDIA GeForce RTX 3090 Ti 24GB 1장에서 진행했고, 엔진마다 Docker 컨테이너 안의 별도 Python 환경에서 실행했습니다.
평가 데이터
| 데이터셋 | 구성 | 길이 | 화자 수 |
|---|---|---|---|
| KCSC 실제 대화(MagicHub ASR-KCSC) | 11대화 · 화자 14명 | 2.69시간 | 2 |
| Nexdata 실제 대화(공개 샘플) | 3대화 | 0.89시간 | 2 |
| 합성 대화(Zeroth-Korean 낭독 문장) | 15세션 · 화자 10명 | 0.77시간 | 2~6 |
로그인 없이 받을 수 있는 한국어 실제 대화 데이터는 2인 대화뿐이어서, 3인 이상은 서로 다른 사람이 읽은 문장을 화자를 바꿔 가며 이어 붙인 합성 대화로 평가했습니다. 화자가 바뀌는 지점의 15% 는 발화가 겹치도록 구성했습니다. 정답 화자 구간은 화자별 채널(실제 대화)이나 원본 발화(합성 대화)의 소리 크기를 기준으로 발화 안의 묵음을 제거해 다듬었습니다.
평가 지표
- DER 은 화자분리 오류율입니다. 실제로 말한 시간 가운데 말소리를 놓친 시간, 말이 없는 곳을 말로 잡은 시간, 화자를 바꿔 붙인 시간의 비율입니다.
- CER 은 문자 오류율입니다. 띄어쓰기와 문장부호를 지운 뒤 정답 글자 수 대비 틀린·빠진·더해진 글자의 비율을 계산하며, 화자는 따지지 않습니다.
- cpCER 은 화자까지 맞혀야 하는 문자 오류율입니다. 다화자 회의 전사 평가에 쓰는 cpWER(CHiME-6 챌린지 공식 지표)를 글자 단위로 바꾼 것으로, 화자별로 발화를 이어 붙인 뒤 오류가 가장 적은 정답·출력 화자 짝을 골라 계산합니다. 다른 화자에게 붙은 글자는 빠진 글자와 더해진 글자로 두 번 세어집니다.
- RTF 는 처리 시간을 녹음 길이로 나눈 값입니다. RTF 0.02 는 1시간 녹음을 72초에 처리한다는 뜻입니다. 모델을 불러오는 시간은 제외했습니다.
- VRAM 은 엔진을 단독으로 실행했을 때 GPU 메모리 사용량의 최댓값입니다.
화자분리 결과
| 모델 | KCSC DER | Nexdata DER | 합성 DER | 합성 5~6인 DER | RTF | VRAM |
|---|---|---|---|---|---|---|
| Nemotron-3-Diarization | 11.5% | 16.2% | 8.9% | 10.6% | 0.0027 | 1.5GB |
| Sortformer v2 | 11.5% | 17.2% | 13.7% | 20.7% | 0.0031 | 1.7GB |
| Sortformer v2.1 | 13.7% | 19.8% | 14.6% | 23.0% | 0.0030 | 1.7GB |
| pyannote community-1 | 17.8% | 21.5% | 5.9% | 7.3% | 0.0158 | 10.4GB |
| DiariZen v2 범용판 | 14.1% | 14.3% | 5.8% | 7.8% | 0.0365 | 12.5GB |
실제 2인 대화에서는 Sortformer 계열이 가장 정확하고 빨랐습니다. KCSC 에서 Nemotron-3 과 Sortformer v2 가 모두 11.5% 였고 화자를 혼동한 오류는 0.1~0.2% 였습니다. 오류 대부분은 상대 말과 겹친 구간이나 1초 미만의 맞장구를 놓친 것이며, 발화 경계 앞뒤 0.25초를 채점에서 빼면 DER 이 2% 안팎으로 내려갑니다.
화자 수가 늘면 모델 구조의 차이가 드러납니다. 한 번에 4명까지 구분하는 Sortformer v2·v2.1 은 5~6인 대화에서 DER 이 20% 를 넘었고, 8명까지 구분하는 Nemotron-3 은 10.6% 였습니다. 짧은 구간마다 화자 임베딩을 추출해 군집화하는 pyannote 와 DiariZen 은 7~8% 로 가장 낮았지만, 처리 시간이 Nemotron-3 의 6~13배였고 GPU 메모리를 10GB 이상 썼습니다.
음성 인식 결과
| 모델 | KCSC CER | Nexdata CER | 합성 CER | RTF | VRAM |
|---|---|---|---|---|---|
| WhisperX large-v3-turbo | 18.8% | 13.1% | 6.6% | 0.0154 | 6.2GB |
| WhisperX large-v3 | 19.6% | 14.3% | 5.8% | 0.0216 | 11.7GB |
| BuzzASR-ko | 16.3% | 10.6% | 6.1% | 0.0213 | 11.8GB |
| Nemotron 3.5 ASR 0.6B | 19.2% | 16.5% | 5.9% | 0.0114 | 8.2GB |
| Qwen3-ASR 1.7B | 15.7% | 11.3% | 6.4% | 0.0332 | 10.0GB |
| Qwen3-ASR 0.6B | 19.0% | 14.1% | 7.6% | 0.0322 | 7.5GB |
낭독 문장으로 만든 합성 대화에서는 모든 모델이 5.8~7.6% 로 비슷했지만, 실제 대화에서는 차이가 벌어졌습니다. Qwen3-ASR 1.7B 가 KCSC 에서 15.7%, 한국어로 미세조정한 BuzzASR-ko 가 Nexdata 에서 10.6% 로 가장 낮았고, 낭독체에서 오류율이 낮았던 Nemotron 3.5 ASR 은 실제 대화에서 19.2%·16.5% 였습니다.
실제 대화 오류의 상당 부분은 표기 규칙의 차이입니다. 정답 전사는 말한 그대로의 구어 표기(같애)와 숫자의 한글 표기(열두 시), 간투사(어, 음)를 남기지만, 음성 인식 모델은 정돈된 문어 표기(같아, 12시)로 적고 간투사를 생략합니다. 간투사만 제외하고 다시 채점해도 Whisper 계열의 CER 이 1.1~2.2%p 내려갑니다.
Qwen3-ASR 은 긴 녹음을 기본값인 180초 대신 30초 단위로 나눠 입력해야 했습니다. 예비 시험에서 이렇게 바꾸자 합성 대화의 CER 이 12.9% 에서 5.8% 로 줄고 처리가 5.5배 빨라졌습니다.
화자분리와 음성 인식을 합친 결과
| 조합 | KCSC cpCER | Nexdata cpCER | 합성 cpCER | RTF 합 |
|---|---|---|---|---|
| Sortformer v2 + WhisperX turbo | 21.9% | 19.0% | 23.5% | 0.019 |
| Nemotron-3 + WhisperX turbo | 22.0% | 16.6% | 13.7% | 0.018 |
| Nemotron-3 + BuzzASR-ko | 20.0% | 14.0% | 13.2% | 0.024 |
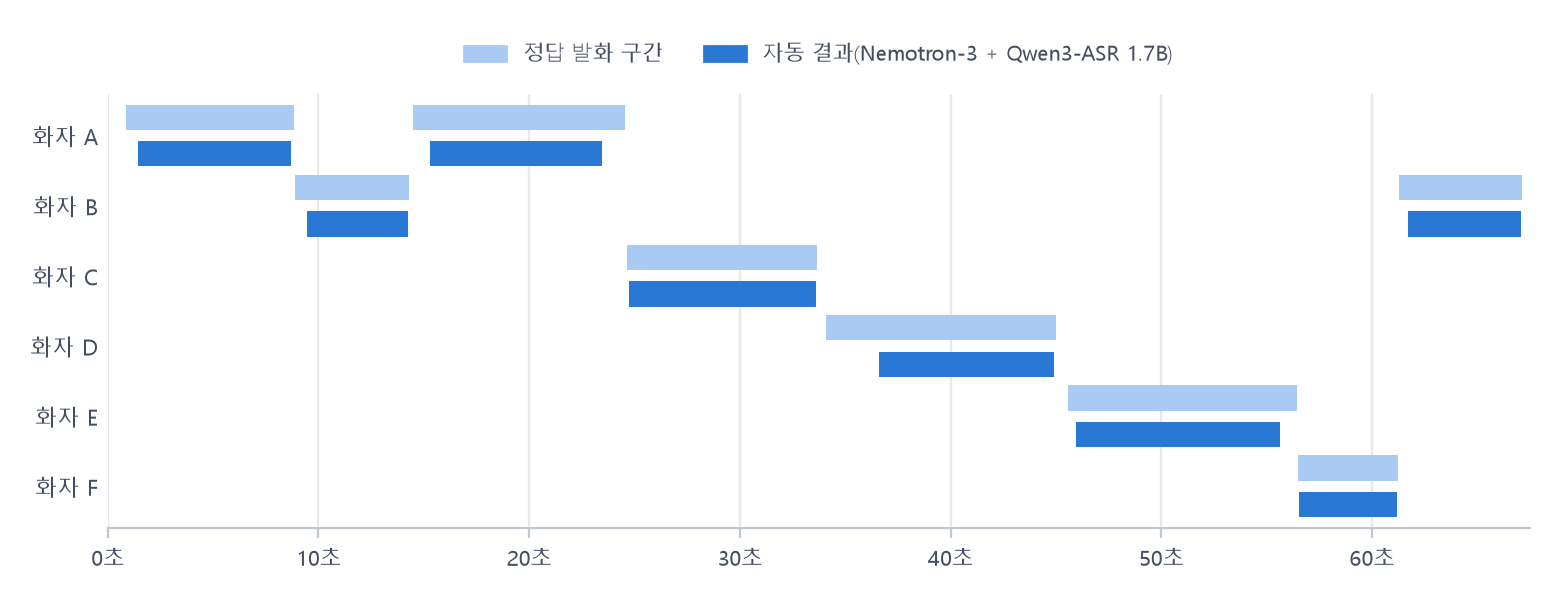
| Nemotron-3 + Qwen3-ASR 1.7B | 18.0% | 12.5% | 13.3% | 0.036 |
| DiariZen v2 + Qwen3-ASR 1.7B | 17.1% | 13.2% | 9.3% | 0.070 |
실제 2인 대화에서는 음성 인식 모델이 결과를 좌우했습니다. Nemotron-3 + Qwen3-ASR 1.7B 는 Nemotron-3 + WhisperX turbo 보다 KCSC 11개·Nexdata 3개 대화 모두에서 cpCER 이 낮았습니다. 대화별 차이의 중앙값은 KCSC 4.7%p, Nexdata 4.0%p 였습니다. 처리 시간은 두 배로 늘지만 1시간 녹음을 약 2분에 처리합니다.
화자가 많은 합성 대화에서는 화자분리가 결과를 좌우했습니다. 4명까지 구분하는 Sortformer v2 조합의 cpCER 이 23.5% 였습니다. DiariZen 조합은 다화자에서 가장 정확했지만 가중치가 비상업 라이선스이고 처리 시간이 Nemotron-3 + Qwen3-ASR 의 두 배였습니다.
통합형 모델 VibeVoice-ASR
VibeVoice-ASR 은 음성을 입력하면 시작·끝 시각, 화자 번호, 내용을 JSON 으로 한 번에 출력하는 모델입니다. 가중치가 16.6GB 라 15GB 안에서 실행하기 위해 언어 모델 부분만 4bit 로 양자화하고 음성 인코더는 BF16 정밀도를 유지했습니다. Nexdata 실제 대화와 합성 대화로 평가했습니다.
| 데이터셋 | DER | CER | cpCER | RTF |
|---|---|---|---|---|
| Nexdata 실제 대화 | 26.8% | 11.3% | 11.3% | 0.59 |
| 합성 대화 | 12.3% | 5.2% | 13.9% | 0.47 |
Nexdata 의 cpCER 11.3% 는 모든 조합 가운데 가장 낮았고, CER 과의 차이가 0.02%p 에 불과해 2인 대화의 화자 구분이 정확했습니다. 합성 대화에서는 15개 가운데 9개만 화자 수를 맞게 추정해 cpCER 이 Nemotron-3 + WhisperX turbo(13.7%)와 비슷했습니다. 발화 구간을 문장 단위로 검출해 DER 이 높았고, 처리 속도는 Nemotron-3 + Qwen3-ASR 보다 13~16배 느렸습니다.
Nemotron-3 미세조정 실험
Nemotron-3-Diarization 을 평가에 쓰지 않은 화자 105명의 낭독 문장으로 만든 합성 대화 240개(6.32시간)로 미세조정했습니다. NeMo 공식 학습 방법으로 600스텝에 9.7분이 걸렸고, 학습 작업의 GPU 메모리는 최대 8.4GB 였습니다.
| 데이터셋 | 미세조정 전 DER | 미세조정 후 DER |
|---|---|---|
| 합성 대화 | 8.9% | 1.7% |
| Nexdata 실제 대화 | 16.2% | 12.9% |
| KCSC 실제 대화 | 11.5% | 11.3% |
합성 대화와 Nexdata 에서는 DER 이 줄었지만 KCSC 는 거의 같았고, 화자별 전사(cpCER)에서는 실제 대화의 개선이 나타나지 않았습니다(KCSC 22.0% → 22.9%, WhisperX turbo 조합). 합성 낭독 대화만으로 학습한 결과입니다.
서비스 구성
실제 대화의 정확도를 우선해 서비스에는 Nemotron-3-Diarization + Qwen3-ASR 1.7B 를 채택했습니다. FastAPI 서버를 Docker 이미지로 만들었고, 컨테이너가 시작될 때 두 모델을 미리 불러 둔 뒤 파일을 받으면 화자별 발화를 JSON·SRT·VTT·TXT·RTTM 으로 반환합니다. 영상 파일은 ffmpeg 로 첫 오디오 트랙을 16kHz 모노로 추출해 처리합니다.
docker compose --profile api build api
docker compose --profile api up -d api
curl -F "file=@meeting.mp4" "http://localhost:8000/transcribe?format=json"서비스로 KCSC 대화 하나(589초)를 처리하는 데 31초가 걸렸고, GPU 메모리는 9.8GB 를 사용했습니다. Qwen3-ASR 은 30초 구간 16개를 한 번에 처리하므로 3분 안팎의 짧은 파일은 상대적으로 느리고(RTF 0.10), 녹음이 길수록 효율이 좋아집니다.
정리
- 실제 2인 대화의 화자분리는 Sortformer 계열이 가장 정확하고 빨랐습니다(KCSC DER 11.5%, RTF 0.003). 5인 이상에서는 8명까지 구분하는 Nemotron-3 이 4명 제한인 Sortformer v2 보다 정확했습니다.
- 실제 대화의 화자별 전사 정확도는 음성 인식 모델이 좌우했습니다. Qwen3-ASR 1.7B 를 결합하자 cpCER 이 약 4%p 낮아졌고, 이 조합을 서비스에 채택했습니다.
- 통합형 VibeVoice-ASR 은 Nexdata 에서 가장 정확했지만 처리 속도가 13~16배 느려 서비스 구성에서 제외했습니다.
- 실제 다화자 공개 데이터가 2인 대화뿐이어서 3인 이상은 합성 낭독 대화로만 평가했습니다. 실제 회의의 끼어들기·짧은 맞장구·원거리 마이크 조건은 반영되지 않았습니다.
- 실제 대화의 오류율에는 구어 표기·숫자 표기 같은 표기 규칙 차이가 포함되어 있어, 절대값보다 같은 조건에서의 상대 비교로 해석해야 합니다.