현장 카메라 영상에서 사람을 찾는 일은 YOLO 같은 객체 탐지기로 충분하지만, 찾은 사람이 안전모와 반사 안전조끼를 착용했는지, 사다리 위에 사람이 있는지처럼 상태와 관계를 판정하려면 판정 항목마다 라벨을 모아 다시 학습해야 합니다. 이미지와 문장을 함께 이해하는 VLM(시각 언어 모델)을 쓰면 판정 항목을 문장으로 바꾸기만 하면 됩니다. 문제는 속도와 자원입니다. 이 글은 Qwen3-VL-4B 를 16GB 노트북 GPU 에서 실행해 VLM 으로 직접 탐지하는 방식과, YOLO 상자에 VLM 판정을 결합하고 그 판정 단계에 Visual Jev 구조를 적용한 방식을 YOLO11·YOLO-World 와 정확도·속도·VRAM·GPU 사용량·초기화 시간·연속 처리로 비교한 기록입니다.
VLM 객체 탐지와 기존 탐지기의 차이
고정 클래스 탐지기는 학습한 클래스만 찾습니다. COCO 로 학습한 YOLO11 은 사람·차량 등 80종을 찾지만 "안전모를 쓰지 않은 사람" 은 찾지 못합니다. 개방 어휘 탐지기는 클래스 이름을 텍스트로 받아 재학습 없이 새 클래스를 찾습니다. VLM 은 자유 문장으로 대상을 지정하고 좌표를 텍스트로 생성합니다. 대상을 문장으로 지정해 이미지 안의 위치로 연결하는 작업을 그라운딩(visual grounding)이라고 부릅니다.
| 방식 | 대표 모델 | 대상 지정 | 장점 | 한계 |
|---|---|---|---|---|
| 고정 클래스 탐지기 | YOLO11 | 학습한 클래스 번호 | 수 ms 단위, 작은 메모리 | 새 클래스마다 라벨링·재학습 |
| 개방 어휘 탐지기 | YOLO-World | 클래스 이름 텍스트 | 재학습 없이 새 이름 사용, 실시간 | 짧은 명사 수준, 속성·관계 판정이 약함 |
| VLM 그라운딩 | Qwen3-VL | 자유 문장 | 속성·관계·예외까지 문장으로 지정 | 좌표를 토큰으로 생성해 느리고 무거움 |
Qwen3-VL 은 상자를 {"bbox_2d": [x1, y1, x2, y2]} 형태의 텍스트로 출력하며, 좌표는 이미지 크기와 무관하게 0~1000 으로 정규화됩니다.
VLM 을 탐지에 쓰는 두 가지 방식
- 생성형 그라운딩: VLM 이 모든 상자를 JSON 으로 직접 생성합니다. 구현이 가장 단순하지만 상자 하나에 수십 토큰을 하나씩 생성하므로 대상이 많을수록 느려집니다.
- 판정형 2단계: 빠른 탐지기가 후보 상자를 찾고, VLM 은 상자마다 "안전모를 썼는가" 같은 객관식 질문에 답합니다. 답을 문장으로 생성하지 않고 후보 글자(A, B, C)의 확률만 읽으므로 생성형보다 훨씬 빠릅니다.
판정형에서 상자 영역을 잘라 VLM 에 입력하면 입력 이미지가 상자마다 달라집니다. 원본 이미지는 그대로 두고, 상자는 질문 문장 속 좌표로 지정했습니다. 이렇게 하면 모든 질문이 같은 이미지를 공유하므로 다음 절의 구조를 적용할 수 있습니다.
판정 단계에 적용한 Visual Jev 구조
같은 이미지에 상자 수 × 판정 항목 수만큼 질문이 생기는데, 질문마다 이미지를 다시 입력하면 이미지 인코딩과 이미지 토큰 수백 개의 계산이 질문 수만큼 반복됩니다. 2026년 9월 공개된 Visual Jev(arXiv:2609.25845)는 이 반복을 없애는 실행 구조입니다. 시스템 지시·이미지·공통 문맥을 접두부로 한 번만 계산해 KV 캐시(어텐션의 키·값 텐서)로 저장하고(접두부 캐싱), 캐시를 질문 수만큼 복제한 뒤 질문별 입력만 한 배치로 묶어 계산합니다(접미부 배치). 판정 단계에서는 각 질문 끝 "Answer:" 위치에서 언어 모델 헤드가 출력하는 로짓 가운데 후보 글자 토큰의 값만 골라 정규화합니다.
논문은 Qwen3-VL-4B 와 RTX 5090 에서 이미지당 질문 32개일 때 질문당 5.7ms 로, 질문을 하나씩 독립 실행할 때(50.7ms)보다 8.9배 빨랐다고 보고했습니다. 질문이 1개뿐이면 캐시를 만드는 비용 때문에 오히려 느립니다. 구현에서는 공식 저장소의 접두부 공유 배치 경로를 간소화하고, VRAM 에 맞춰 질문을 나누는 처리를 추가했습니다(구현 코드 절).
측정 환경과 비교 구성
| 항목 | 내용 |
|---|---|
| 장비 | RTX 5080 Laptop GPU(VRAM 16GB), Windows(WDDM). 화면 출력이 같은 GPU 를 사용해 측정 전 1.8~2.7GiB 점유 |
| 전력 | GPU 전력 한도가 부하·온도에 따라 바뀜. 같은 사진 반복 측정 때 90W, 연속 처리 측정 때 최대 132W |
| 소프트웨어 | torch 2.14.0(CUDA 13.0), ultralytics 8.4.175, transformers 5.17.0 |
| 입력 | 건설 현장 사진 1장(896×670)과 이 사진에 카메라 이동을 적용해 만든 서로 다른 프레임 120장 |
| 정답 | 사진을 직접 보고 정한 값. 작업자 12명(2명은 다른 사람에게 대부분 가려짐), 상자가 뚜렷한 10명의 안전모·조끼 착용 20건, 장면 질문 5건 |
| 측정 방법 | 구성마다 새 프로세스를 띄워 프로세스 생성부터 첫 결과까지를 초기화 시간으로 기록. 20ms 간격으로 GPU 사용률·메모리·전력·온도·클럭 수집 |
| 구성 | 모델 | 하는 일 |
|---|---|---|
| YOLO11n | yolo11n.pt (5.6MB) | 사람 검출(COCO 클래스 0) |
| YOLO11m | yolo11m.pt (40.7MB) | 사람 검출(COCO 클래스 0) |
| YOLO-World | yolov8l-worldv2.pt (94MB) + CLIP 텍스트 인코더 | person · helmet · reflective vest 검출 |
| VLM 그라운딩 | Qwen3-VL-4B-Instruct (bf16, 8.3GiB) | 사람 상자를 JSON 으로 생성 |
| YOLO11m + VLM 판정 | YOLO11m + Qwen3-VL-4B | 상자마다 안전모·조끼 질문 2개 + 장면 질문 5개를 Visual Jev 구조로 판정. 한 배치와 14문항 분할 두 가지 |
YOLO-World 는 같은 사진에서 클래스 이름 조합 7가지를 시험해 가장 결과가 좋은 조합을 사용했습니다. hard hat · safety vest 조합은 조끼를 하나도 찾지 못했습니다. 출처가 확인되지 않는 제3자 안전장비 전용 YOLO 가중치는 불러올 때 임의 코드가 실행될 수 있어 비교에서 제외했습니다.
정확도 비교
| 구성 | 찾은 사람 상자 | 맞음 | 중복·오검출 | 놓침 | 안전모·조끼 (20건) | 장면 질문 (5건) |
|---|---|---|---|---|---|---|
| YOLO11n | 11 | 10 | 1 | 2 | 판정 불가 | 판정 불가 |
| YOLO11m | 11 | 10 | 1 | 2 | 판정 불가 | 판정 불가 |
| YOLO-World | 15 | 12 | 3 | 0 | 16 | 판정 불가 |
| VLM 그라운딩 | 10 | 10 | 0 | 2 | - | - |
| YOLO11m + VLM 판정 | 11 | 10 | 1 | 2 | 18 | 5 |
- 사람 검출: 뚜렷한 10명은 모든 구성이 찾았습니다. YOLO11 은 같은 사람에 상자를 중복으로 낸 경우가 1건 있었고 VLM 그라운딩은 중복이 없었습니다. 가려진 2명은 YOLO-World 만 찾았지만 중복 상자도 함께 늘었습니다.
- 안전모·조끼: YOLO-World 는 안전모 10명을 모두 찾았으나 조끼는 사진 전체에서 1개만 검출했습니다. 조끼 미착용 4명은 검출이 없어 정답으로 처리된 것입니다. VLM 판정은 조끼 착용자를 모두 맞혔고, 주황·연두색 티셔츠를 조끼로 오인한 2건만 틀렸습니다.
- 장면 질문: 사다리 유무, 위험 표지, 사다리 위 작업자, 존재하지 않는 지게차(전제 오류), 특정 작업자의 안전모 색처럼 상자로 표현되지 않는 질문은 VLM 판정만 답할 수 있습니다.
같은 사진 반복 처리 속도
| 구성 | 평균 | 중앙값 | 95백분위 | 초당 처리 |
|---|---|---|---|---|
| YOLO11n | 13.0ms | 12.5ms | 17.6ms | 76.7장 |
| YOLO11m | 15.4ms | 14.7ms | 19.1ms | 65.1장 |
| YOLO-World | 20.7ms | 20.4ms | 26.8ms | 48.3장 |
| VLM 그라운딩 | 21,197ms | 20,843ms | 22,944ms | 0.05장 |
| YOLO11m + VLM 판정, 한 배치 | 2,622ms | 2,620ms | 2,688ms | 0.38장 |
| YOLO11m + VLM 판정, 14문항 분할 | 1,018ms | 991ms | 1,107ms | 0.98장 |
같은 사진 1장을 반복 입력한 결과입니다. VLM 그라운딩은 작업자 10명의 상자를 생성하는 데 평균 약 21초가 걸려 YOLO11m 의 약 1,400배였습니다. 2단계 구성은 소요 시간의 대부분이 VLM 판정입니다(14문항 분할 기준 탐지 19.4ms + 판정 998.6ms). 이 구성은 그라운딩보다 약 21배 빠르면서 속성 판정 결과까지 함께 제공합니다.
서로 다른 프레임 연속 처리
실제 카메라처럼 매 프레임 내용이 바뀌는 조건을 보기 위해, 현장 사진을 좌우로 이동하고 확대·축소해 서로 다른 프레임 120장(프레임당 작업자 8~13명)을 만들고 구성마다 정해진 시간 동안 연속으로 처리했습니다. 프레임은 미리 메모리에 올려 디스크 읽기 시간을 제외했습니다. 프레임 하나의 처리 시간은 탐지부터 판정 결과까지 전 과정을 측정했습니다.
| 구성 | 연속 처리 | 처리 프레임 | 초당 처리 | 평균 | 95백분위 | 앞 20% → 뒤 20% 평균 |
|---|---|---|---|---|---|---|
| YOLO11n | 60초 | 6,691 | 111.5장 | 9.0ms | 13.3ms | 9.1ms → 8.8ms |
| YOLO11m | 60초 | 4,603 | 76.7장 | 13.0ms | 16.9ms | 13.0ms → 12.9ms |
| YOLO-World | 60초 | 3,586 | 59.8장 | 16.7ms | 19.4ms | 16.4ms → 16.9ms |
| YOLO11m + VLM 판정, 14문항 분할 | 120초 | 132 | 1.10장 | 912ms | 1,008ms | 915ms → 915ms |
| VLM 그라운딩 | 95초 | 5 | 0.05장 | 19,052ms | 22,283ms | 18,025ms → 18,564ms |
| 구성 | GPU 사용률 평균 | 전력 평균 (최대) | 온도 시작 → 끝 | SM 클럭 평균 |
|---|---|---|---|---|
| YOLO11n | 29% | 86W (101W) | 56°C → 76°C | 2,737MHz |
| YOLO11m | 59% | 96W (132W) | 67°C → 82°C | 2,345MHz |
| YOLO-World | 73% | 99W (107W) | 61°C → 81°C | 2,226MHz |
| YOLO11m + VLM 판정, 14문항 분할 | 92% | 96W (131W) | 74°C → 87°C | 1,665MHz |
| VLM 그라운딩 | 46% | 98W (107W) | 80°C → 85°C | 2,413MHz |
- YOLO 는 실시간 처리 여유가 큽니다. YOLO11m 은 초당 76.7장으로 30fps 카메라 약 2.6대분을 처리합니다.
- VLM 판정 구성은 프레임당 0.91초(탐지 17.7ms + 판정 894ms)였습니다. 프레임마다 질문이 평균 25.7개였고 질문당 34.9ms 였습니다. 30fps 영상의 모든 프레임은 판정할 수 없으므로, 탐지는 매 프레임 YOLO 로 하고 VLM 판정은 카메라 1대당 약 1초 간격으로 일부 프레임에만 적용하는 운용이 현실적입니다.
- VLM 그라운딩은 프레임당 약 19초로 95초 동안 5장만 처리했습니다. 연속 탐지 용도로는 쓸 수 없습니다.
- 발열: 2분 연속 판정에서 GPU 온도가 74°C 에서 87°C 까지 올랐고 SM 클럭 평균이 YOLO11n 실행 때보다 낮았습니다. 다만 앞 20% 와 뒤 20% 구간의 평균 처리 시간이 같아 측정 시간 안에서는 점점 느려지는 현상이 나타나지 않았습니다.
- 전력 조건: 연속 처리 측정 때는 전력이 최대 132W 까지 올라가 같은 사진 반복 측정(한도 90W) 때보다 YOLO 가 빨랐습니다. 두 측정의 절대값은 직접 비교하지 않고 같은 표 안의 구성끼리만 비교합니다.
초기화 시간
| 구성 | 라이브러리 적재 | 모델 적재 | 첫 추론 | 프로세스 생성 → 첫 결과 |
|---|---|---|---|---|
| YOLO11n | 4.6초 | 0.2초 | 4.7초 | 9.6초 |
| YOLO11m | 4.3초 | 0.3초 | 4.3초 | 8.9초 |
| YOLO-World | 4.1초 | 6.3초 | 1.0초 | 11.4초 |
| VLM 그라운딩 | 12.3초 | 9.6초 | 16.5초 | 38.4초 |
| YOLO11m + VLM 판정, 한 배치 | 14.5초 | 10.4초 | 4.3초 | 29.2초 |
| YOLO11m + VLM 판정, 14문항 분할 | 13.5초 | 10.0초 | 2.2초 | 25.8초 |
YOLO 의 첫 추론 4초대는 대부분 CUDA 커널 준비 시간입니다. YOLO-World 는 모델 적재 단계에서 CLIP 텍스트 인코더로 클래스 이름을 미리 임베딩합니다. VLM 의 초기화 시간은 transformers 적재와 8.3GiB 가중치 전송이 대부분을 차지합니다. 모델 파일은 미리 내려받아 둔 상태에서 측정했습니다.
VRAM 과 GPU 사용량
| 구성 | PyTorch 최대 할당 | PyTorch 최대 예약 | GPU 사용률 평균 (최대) | 평균 전력 |
|---|---|---|---|---|
| YOLO11n | 0.08GiB | 0.10GiB | 17.6% (25%) | 44.5W |
| YOLO11m | 0.31GiB | 0.41GiB | 40.8% (50%) | 55.5W |
| YOLO-World | 1.64GiB | 1.81GiB | 34.6% (74%) | 48.3W |
| VLM 그라운딩 | 8.48GiB | 8.54GiB | 38.4% (98%) | 88.7W |
| YOLO11m + VLM 판정, 한 배치 | 11.76GiB | 14.45GiB | 96.4% (100%) | 86.6W |
| YOLO11m + VLM 판정, 14문항 분할 | 10.24GiB | 11.73GiB | 92.2% (99%) | 89.0W |
- YOLO 는 GPU 를 모두 사용하지 않습니다. 사진 한 장씩 처리할 때 사용률이 18~41% 에 그쳐 여러 카메라를 묶어 처리할 여유가 있습니다.
- VLM 그라운딩은 사용률 평균이 38% 로 낮지만 전력은 89W 였습니다. 토큰을 하나씩 생성하는 동안 가중치를 매번 메모리에서 읽어야 해 연산 유닛이 기다리는 구간이 길기 때문으로 보입니다.
- VLM 판정은 GPU 를 92~96% 사용합니다. 여러 질문을 한 번에 계산하므로 다른 GPU 작업과 동시에 실행하면 양쪽 모두 크게 느려집니다.
- 질문 분할의 효과: 27문항을 한 배치로 실행하면 PyTorch 예약 메모리가 14.45GiB 까지 늘어 화면 출력 점유와 합쳐 VRAM 용량을 넘었고, Windows 드라이버가 시스템 메모리를 대신 사용하면서 2.6배 느려졌습니다. 같은 접두부 캐시에서 14문항씩 나누면 11.73GiB 로 줄어 VRAM 안에 머물렀습니다. 오류 없이 속도만 떨어지므로 장치 메모리 사용량을 함께 확인해야 합니다.
현장 사진 판정 결과
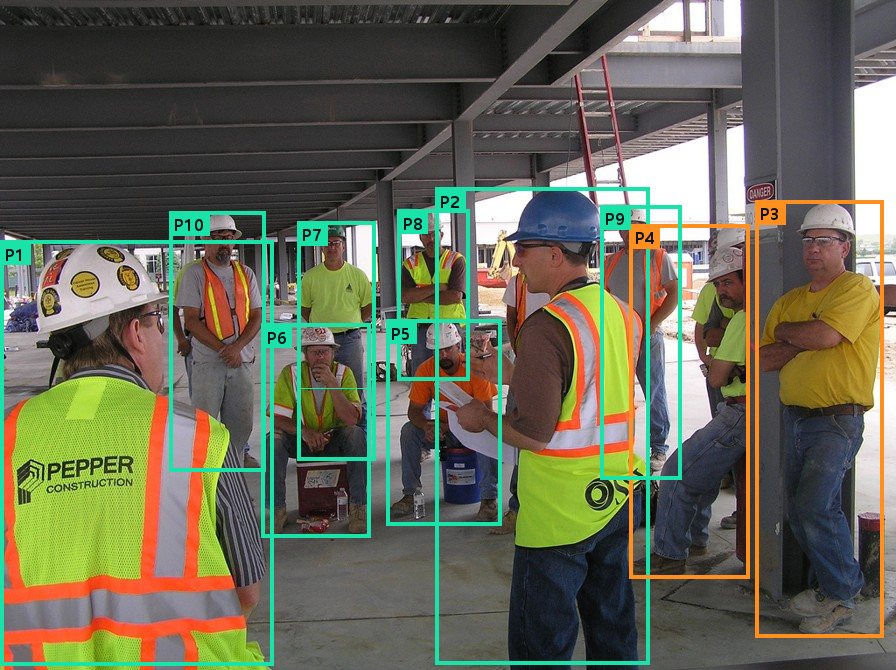
| 상자 | YOLO 신뢰도 | 안전모 판정 | 안전조끼 판정 | 육안 확인 (조끼) | 결과 |
|---|---|---|---|---|---|
| P1 | 0.95 | 착용 (1.00) | 착용 (1.00) | 착용 | 정답 |
| P2 | 0.91 | 착용 (1.00) | 착용 (1.00) | 착용 | 정답 |
| P3 | 0.91 | 착용 (1.00) | 미착용 (1.00) | 미착용(노란 티셔츠) | 정답 |
| P4 | 0.86 | 착용 (0.95) | 미착용 (0.72) | 미착용(연두 티셔츠) | 정답 |
| P5 | 0.86 | 착용 (1.00) | 착용 (0.94) | 미착용(주황 티셔츠) | 조끼 오답 |
| P6 | 0.91 | 착용 (1.00) | 착용 (1.00) | 착용 | 정답 |
| P7 | 0.52 | 착용 (0.97) | 착용 (0.56) | 미착용(연두 티셔츠) | 조끼 오답 |
| P7' | 0.32 | 착용 (0.94) | 착용 (0.50) | 미착용(연두 티셔츠) | 중복 상자 |
| P8 | 0.85 | 착용 (1.00) | 착용 (1.00) | 착용 | 정답 |
| P9 | 0.79 | 착용 (1.00) | 착용 (1.00) | 착용 | 정답 |
| P10 | 0.88 | 착용 (1.00) | 착용 (1.00) | 착용 | 정답 |
| 질문 (실제 입력) | 판정 | 육안 확인 | 결과 |
|---|---|---|---|
| Is there a ladder in the image? | 있음 (1.00) | 있음 | 정답 |
| Is a DANGER sign visible? | 있음 (1.00) | 있음 | 정답 |
| Is anyone standing on the ladder? | 없음 (0.99) | 없음 | 정답 |
| What color is the forklift? | 잘못된 전제 (0.72) | 지게차 없음(뒤쪽에 노란 굴착기만 있음) | 정답 |
| What color is the hard hat of the person in region [P2 좌표]? | 파란색 (1.00) | 파란색 | 정답 |
- 오답 2건은 모두 형광색 티셔츠를 안전조끼로 오인한 경우입니다(P5 확률 0.94, P7 0.56). 같은 색 티셔츠를 입은 P3·P4 는 맞혔습니다. 형광색 작업복이 흔한 현장에서 가장 먼저 나타날 오류 유형이며, 현장 사진으로 만든 LoRA 학습 데이터로 보완할 대상입니다.
- 확률을 함께 봐야 합니다. 맞힌 판정은 대부분 0.95 이상이었지만 P4 조끼(0.72)와 지게차 전제 질문(0.72)은 확률이 낮았고, 틀린 P7 은 0.56 이었습니다. 0.9 미만 판정을 사람 검토로 넘기면 이번 사진의 오답 2건 중 1건을 걸러낼 수 있습니다.
- P7' 은 YOLO11m 이 P7 에 중복으로 낸 상자로 같은 판정이 나왔습니다. 운영에서는 탐지 단계에서 겹치는 상자를 추가로 걸러야 합니다.
구현 코드
측정에 사용한 코드입니다. 환경은 uv 가상환경에 torch 2.14.0(cu130)·transformers 5.17.0·ultralytics 를 설치했습니다. 생성형 그라운딩은 대화 형식으로 이미지를 입력하고 JSON 을 생성하게 한 뒤 좌표만 추출합니다.
import json, re, torch
from transformers import AutoProcessor, Qwen3VLForConditionalGeneration

BASE = "Qwen/Qwen3-VL-4B-Instruct"
model = Qwen3VLForConditionalGeneration.from_pretrained(
    BASE, dtype=torch.bfloat16, device_map="cuda").eval()
proc = AutoProcessor.from_pretrained(BASE)

def ground(image, target="person"):
    msgs = [{"role": "user", "content": [
        {"type": "image", "image": image},
        {"type": "text", "text": f"Locate every {target} in the image. Output a JSON list "
                                 f'where each item has "bbox_2d" [x1, y1, x2, y2] and "label".'}]}]
    enc = proc.apply_chat_template(msgs, tokenize=True, add_generation_prompt=True,
                                   return_dict=True, return_tensors="pt").to("cuda")
    with torch.no_grad():
        gen = model.generate(**enc, max_new_tokens=1024, do_sample=False)
    text = proc.batch_decode(gen[:, enc["input_ids"].shape[1]:], skip_special_tokens=True)[0]
    items = json.loads(re.search(r"\[.*\]", text, re.S).group(0))
return [it["bbox_2d"] for it in items] # 0~1000 정규화 좌표판정 함수는 Visual Jev 공식 코드의 접두부 공유 배치 경로를 간소화하고 질문 분할을 추가한 것입니다. Qwen3-VL 은 위치 번호가 3축(M-RoPE)이라 접미부 위치를 길이로 계산하면 어긋나므로, 전체 시퀀스로 한 번 계산해 잘라 사용합니다. 비전 특징을 언어 모델 앞쪽 층에 다시 더하는 DeepStack 은 이미지 토큰이 모두 접두부에 있으므로 접두부 계산에만 전달합니다.
from transformers.cache_utils import DynamicCache

tok, vl = proc.tokenizer, model.model
IMG = model.config.image_token_id
PAD = tok.pad_token_id or tok.eos_token_id
OPT = torch.tensor([tok(f" {chr(65 + i)}", add_special_tokens=False)["input_ids"][0]
                    for i in range(16)], device="cuda")   # 후보 글자 " A"~" P"

def prefix_text(ctx):
    return ("<|im_start|>system\nChoose exactly one option. Never explain.<|im_end|>\n"
            f"<|im_start|>user\n<|vision_start|><|image_pad|><|vision_end|>\n{ctx}")

def suffix_text(q, opts):
    lines = [f"\n\nQuestion: {q}", "Options:"]
    lines += [f"{chr(65 + i)}. {o}" for i, o in enumerate(opts)]
    lines.append("Reply with the single letter of the correct option.")
    return "\n".join(lines) + "<|im_end|>\n<|im_start|>assistant\nAnswer:"

@torch.no_grad()
def decide(image, ctx, questions, chunk=14):     # questions: [(질문, [후보...]), ...]
    enc = proc(text=[prefix_text(ctx)], images=[image], return_tensors="pt").to("cuda")
    pre, grid = enc["input_ids"][0], enc["image_grid_thw"]
    P = pre.numel()
    sufs = [torch.tensor(tok(suffix_text(q, o), add_special_tokens=False)["input_ids"],
                         device="cuda") for q, o in questions]
    pos = []                                     # M-RoPE: 전체 서열로 계산 후 잘라 씀
    for s in sufs:
        full = torch.cat([pre, s])[None]
        p, _ = vl.get_rope_index(full, mm_token_type_ids=(full == IMG).int(), image_grid_thw=grid)
        pos.append(p[:, 0])
    feats = vl.get_image_features(enc["pixel_values"], grid, return_dict=True)
    emb = vl.get_input_embeddings()(pre).clone()
    vmask = pre == IMG
    emb[vmask] = torch.cat(feats.pooler_output).to(emb.dtype)
    base = DynamicCache()                        # 접두부 1회 계산 (DeepStack 포함)
    vl.language_model(inputs_embeds=emb[None], position_ids=pos[0][:, None, :P],
                      past_key_values=base, visual_pos_masks=vmask[None],
                      deepstack_visual_embeds=feats.deepstack_features, use_cache=True)
    logits = []
    for c0 in range(0, len(sufs), chunk):          # VRAM 에 맞춰 질문을 나눔
        cs, cp = sufs[c0:c0 + chunk], pos[c0:c0 + chunk]
        n, S = len(cs), max(s.numel() for s in cs)
        ids = torch.full((n, S), PAD, device="cuda")
        spos = torch.zeros(3, n, S, dtype=torch.long, device="cuda")
        attn = torch.zeros(n, P + S, dtype=torch.long, device="cuda")
        attn[:, :P] = 1
        for i, s in enumerate(cs):                 # 왼쪽 채움: 판정 위치가 마지막 열
            L = s.numel()
            ids[i, S - L:], spos[:, i, S - L:], attn[i, P + S - L:] = s, cp[i][:, P:], 1
        cache = DynamicCache()
        for li, layer in enumerate(base.layers):
            cache.update(layer.keys.expand(n, -1, -1, -1).contiguous(),
                         layer.values.expand(n, -1, -1, -1).contiguous(), li)
        out = vl.language_model(inputs_embeds=vl.get_input_embeddings()(ids), position_ids=spos,
                                attention_mask=attn, past_key_values=cache, use_cache=True)
        logits.append(model.lm_head(out.last_hidden_state[:, -1])[:, OPT].float())
    logits = torch.cat(logits)
    return [dict(zip(o, torch.softmax(logits[i, :len(o)], -1).tolist()))
for i, (_, o) in enumerate(questions)]YOLO 상자를 0~1000 좌표로 변환해 질문을 만들고 판정 함수에 전달합니다.
from ultralytics import YOLO

det = YOLO("yolo11m.pt")
r = det.predict(frame_bgr, imgsz=640, conf=0.25, classes=[0], verbose=False)[0]
W, H = image.size
boxes = [[round(v * 1000 / s) for v, s in zip(b, (W, H, W, H))] for b in r.boxes.xyxy.tolist()]
CTX = "This is a photo of a construction site. Region coordinates are [x1, y1, x2, y2] on a 0-1000 scale."
qs = []
for b in boxes:
    qs.append((f"Is the person in region {b} wearing a hard hat?", ["yes", "no", "cannot tell"]))
    qs.append((f"Is the person in region {b} wearing a high-visibility safety vest over their clothes?",
               ["yes, a reflective safety vest", "no, only a regular or colored shirt", "cannot tell"]))
answers = decide(image, CTX, qs, chunk=14)- 분할 크기는 VRAM 산식으로 결정합니다. 질문 1개당 추가 메모리는 접두부 토큰 수 × 0.14MiB(Qwen3-VL-4B: 36층 × KV 헤드 8 × 차원 128 × 키·값 × 2바이트)이고, 670토큰 접두부면 질문당 약 92MiB 입니다. 가중치 8.3GiB 에 분할 크기 × 질문당 메모리와 여유 2GiB 를 더한 값이 화면 출력 점유를 뺀 여유 VRAM 을 넘지 않도록 정합니다.
- 거절 후보를 포함합니다. 판정은 주어진 후보 밖의 답을 낼 수 없으므로 cannot tell · incorrect_question 같은 후보가 있어야 가림·저해상도·전제 오류를 처리할 수 있습니다.
- bfloat16 배치 계산은 질문을 하나씩 실행할 때와 확률이 미세하게 다릅니다. 1·2위 차이가 작은 문항에서는 선택이 바뀔 수 있습니다.
용도별 선택 기준
| 용도 | 권장 구성 | 근거 |
|---|---|---|
| 실시간 영상, 고정 클래스(사람·차량) | YOLO11 | 15ms 이하, VRAM 1GiB 미만, 초기화 9초 |
| 학습 데이터 없는 새 물체 이름 | YOLO-World | 이름만 바꿔 실시간 검출. 조끼처럼 잘 잡히지 않는 이름은 사전 확인 필요 |
| 착용·상태·관계 판정 | YOLO + VLM 판정(Visual Jev) | 프레임당 약 0.9~1초. 속성 판정 정확도가 가장 높고 장면 질문까지 처리 |
| 소량 이미지의 일회성 탐지, 라벨 초안 생성 | VLM 그라운딩 | 문장으로 대상 지정, 중복 상자 없음. 이미지당 약 20초 |
| 엣지 장비·다수 카메라 동시 처리 | VLM 사용 불리 | VRAM 9~12GiB, GPU 사용률 90% 이상 점유 |
정리
16GB 노트북 GPU 에서 Qwen3-VL-4B 는 별도 학습 없이 사람을 YOLO11 수준으로 찾았지만, 좌표를 생성하는 방식이라 이미지당 약 20초로 연속 탐지에는 쓸 수 없었습니다. VLM 의 강점은 상자를 찾는 일보다 찾은 상자의 속성과 장면을 판정하는 일에 있습니다. YOLO 가 상자를 찾고 VLM 이 Visual Jev 구조로 질문을 묶어 판정하면 서로 다른 프레임을 2분 동안 연속 처리해도 프레임당 0.91초가 유지되었고 안전모·조끼 판정 18/20, 장면 질문 5/5 를 얻었습니다.
- 정확도는 사진 1장을 육안으로 대조한 값이라 일반화할 수 없습니다. 현장 사진 수백 장 규모의 평가가 필요합니다.
- 형광색 티셔츠를 조끼로 판정하는 오류는 원본 모델의 한계이며, 현장 데이터로 LoRA 를 학습해 보완할 대상입니다.
- VLM 판정 구성은 VRAM 12GiB 이상과 GPU 사용률 90% 이상을 차지합니다. 다른 GPU 작업과 함께 운용하려면 판정 주기를 늘려야 합니다.
- 2분 넘는 장시간 연속 운용에서 발열에 따른 성능 변화는 측정하지 않았습니다.