Hailo-15H 카메라에 탐지 모델 탑재
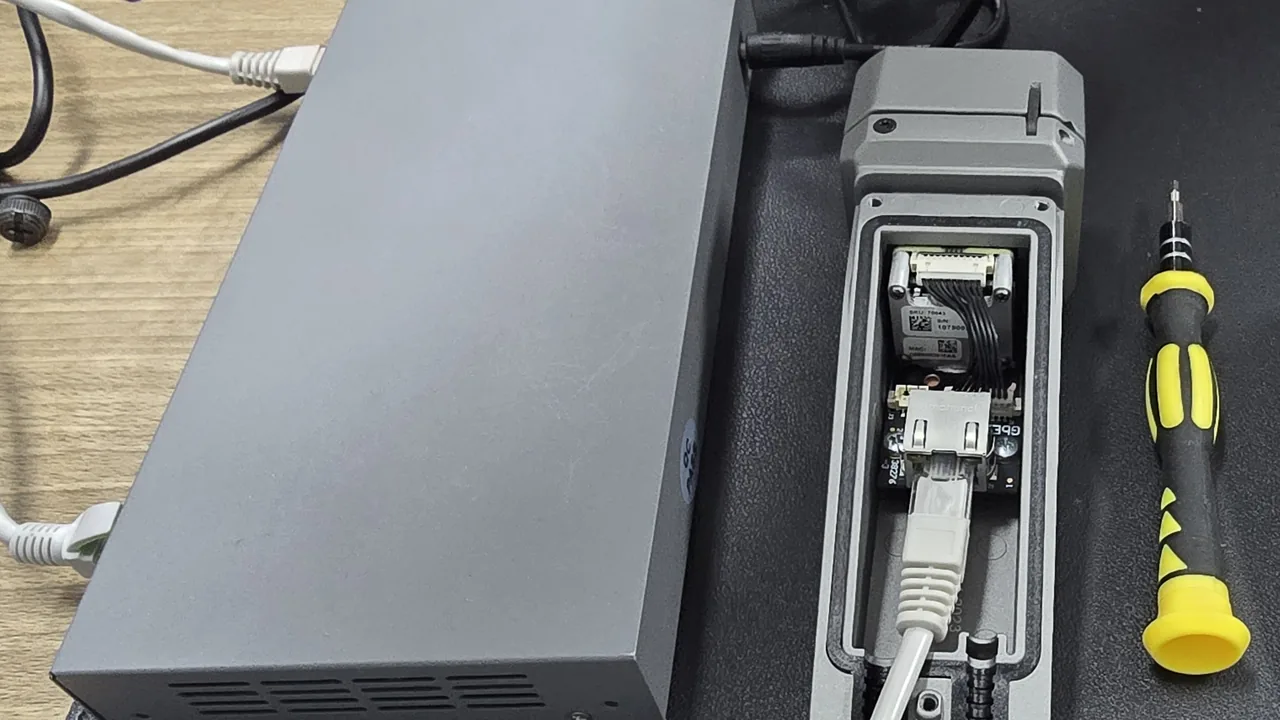
Hailo-15H 카메라에 속성 헤드를 붙인 탐지 모델을 올려 본 기록입니다. D-FINE 은 미지원 연산 3종으로 변환에 실패했고 YOLO26 은 구동에 성공했으며, 버전 불일치·저장 공간·발열의 실측을 정리합니다.
공개 모델과 논문 코드를 같은 조건에서 직접 돌려 정확도·속도·메모리를 잰 글입니다. 16GB 노트북 GPU 에서 VLM 그라운딩과 Visual Jev 구조를 YOLO11·YOLO-World 와 비교했고, 화자분리 6종과 음성 인식 6종, 통합형 1종을 실제·합성 다화자 대화로 견주어 전사 조합을 골랐습니다.
배포 단계의 측정도 함께 묶었습니다. RTX 3090 Ti 한 장에 도구 호출을 지원하는 멀티모달 모델 네 종을 올린 비교, Hailo-15H 카메라의 모델 변환 실패와 구동 성공 사례, 브라우저 WebGPU 추론의 제출 횟수와 완료 대기 측정, GPU 에서 압축한 COSA-GS 파일을 CPU 에서 복원한 결과를 다룹니다.
Hailo-15H 카메라에 속성 헤드를 붙인 탐지 모델을 올려 본 기록입니다. D-FINE 은 미지원 연산 3종으로 변환에 실패했고 YOLO26 은 구동에 성공했으며, 버전 불일치·저장 공간·발열의 실측을 정리합니다.
Qwen3-VL-4B 로 객체를 직접 찾는 VLM 그라운딩과, YOLO 상자에 Visual Jev 구조로 속성을 판정하는 2단계 구성을 16GB 노트북 GPU 에서 YOLO11·YOLO-World 와 정확도·속도·VRAM·연속 처리로 비교했습니다.
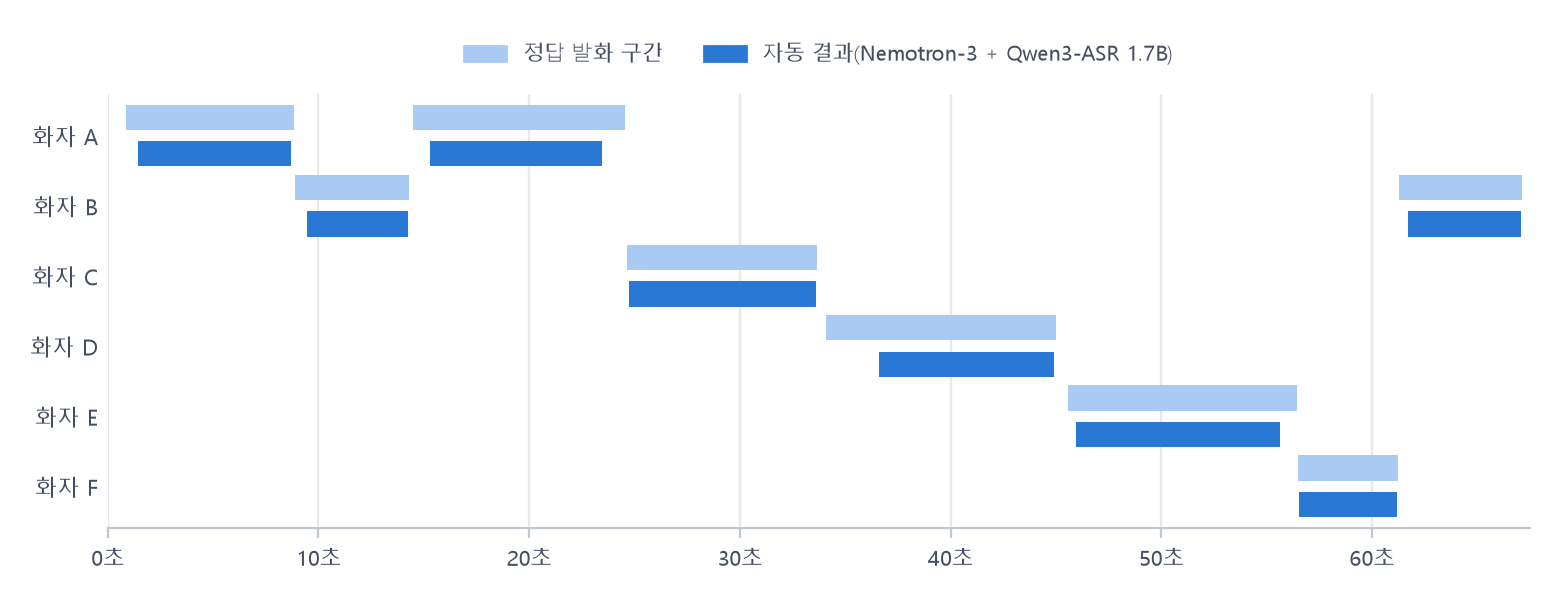
화자분리 6종(pyannote 등)·음성 인식 6종(WhisperX·Qwen3-ASR 등)·통합형 1종을 실제·합성 다화자 대화로 비교했습니다. 실제 대화의 화자별 전사 오류율(cpCER)이 가장 크게 낮아진 Nemotron-3 + Qwen3-ASR 1.7B 조합을 채택했습니다.
3D 가우시안 스플래팅 압축 COSA-GS 를 공개 코드로 학습시켜 74MB 장면을 4.9MB 로 줄이고, GPU 에서 압축한 파일을 CPU 에서 복원했습니다. 부동소수점 모델은 확률표 인덱스 3곳이 어긋난 뒤 심볼 77% 가 틀렸고, 정수 추론 모델은 심볼이 모두 같았습니다.
브라우저에서 언어 모델을 돌릴 때 GPU 에 작업을 몇 번 나눠 보내는지가 속도를 얼마나 바꾸는지 직접 쟀습니다. 제출 횟수보다 완료를 기다리는 지점이 훨씬 비쌌고, 모델과 문맥이 커질수록 그 차이는 사라졌습니다.
도구 호출을 지원하는 공개 가중치 멀티모달 모델 네 종을 RTX 3090 Ti 한 장에 올려 VRAM 점유, 생성 속도, 이미지 판독, 코딩, 도구 호출, 수정 금지 구간 준수, 대화 맥락 유지를 같은 조건으로 측정한 기록입니다.
내부망 포털에 모인 훈련 손실과 mAP, 정밀도, 재현율을 어떤 순서로 확인해야 하는지 정리했습니다. 숫자 하나로 모델을 고르지 않고 데이터 기준, 추이, 클래스별 오류, 운영 속도까지 연결해 판단하는 방법입니다.